


 +375445023245
 +375445023245
Коротко за 30 секунд
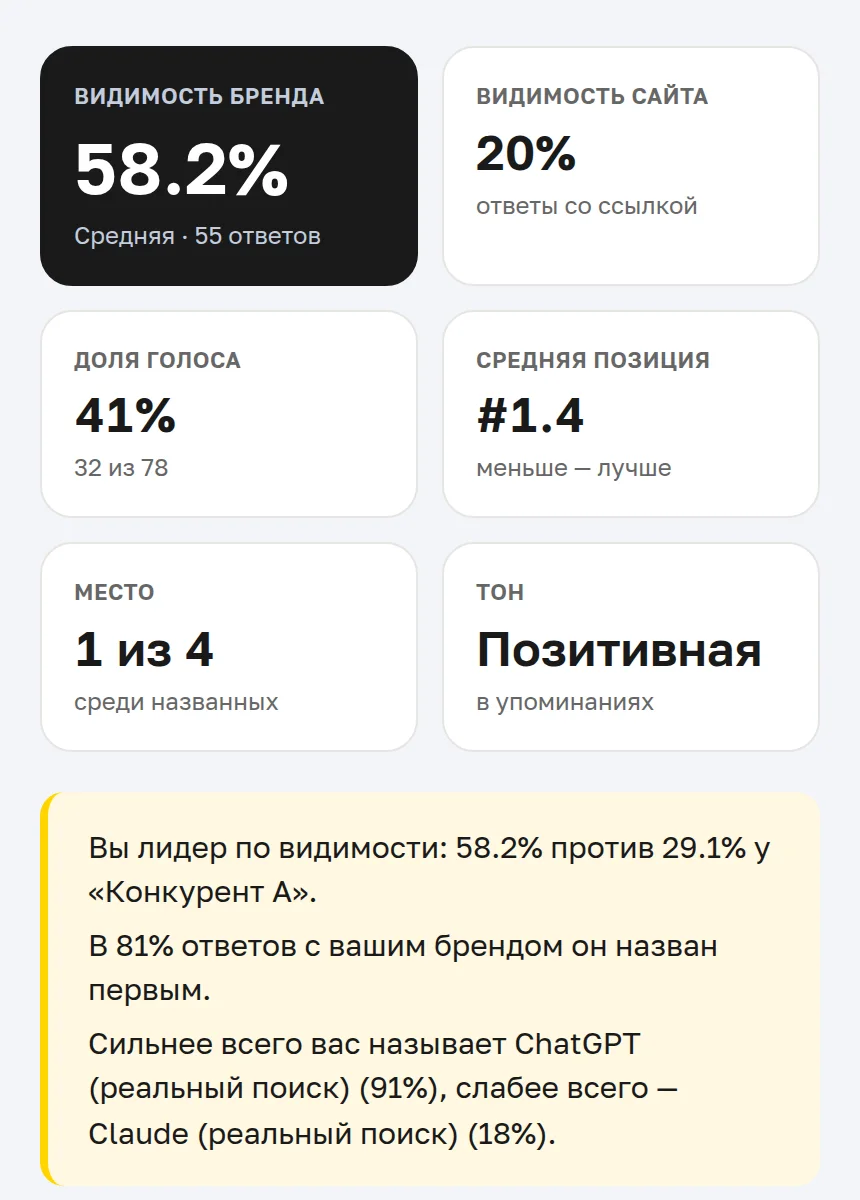
- У нас один и тот же сайт в один день получил 29% и 6% видимости: в первом замере были вопросы с названием бренда, во втором только открытые вопросы без него.
- Цифра видимости без описания замера ничего не значит: нужны состав вопросов, список нейросетей, число прогонов, регион, дата и правило подсчёта.
- Десять ловушек ниже объясняют, откуда берутся расхождения, и к каждой дан чек-лист.
- Сравнивать можно только замеры с одинаковыми условиями. Всё остальное это разные измерения под одним названием.
Знакомая ситуация: вы получили отчёт, где видимость бренда в нейросетях 29%. Через неделю другой подрядчик или другой инструмент показывает 6%. Кто-то ошибся? Чаще всего нет: просто замерены разные вещи. У нас это произошло на собственном проекте, и разбор оказался полезнее любой теории.
Ниже мы разбираем ловушки замера по порядку: как каждая выглядит в отчёте, почему она двигает цифру и что проверить до того, как вы покажете число руководителю или клиенту. Сами метрики (видимость, AI SOV, citation share) мы подробно объяснили в статье про метрики GEO, определения GEO есть в хабе про GEO. Здесь только то, что ломает замер.
Содержание
- Один сайт, два замера: 29% и 6%
- Ловушка 1. Состав набора вопросов
- Ловушка 2. Формулировка вопроса
- Ловушка 3. Формула подсчёта
- Ловушка 4. Число и набор нейросетей
- Ловушка 5. Ответ из памяти и ответ с поиском
- Ловушка 6. Повторные прогоны
- Ловушка 7. Регион и язык
- Ловушка 8. Знаменатель и запросы без AI-блока
- Ловушка 9. Дата замера и смена моделей
- Ловушка 10. Один замер вместо серии
- Сводный чек-лист и что делать сайту
- Частые вопросы
- Источники
Один сайт, два замера: 29% и 6%
Расскажем про свой кейс, подробный разбор лежит в кейсе про рост в ответах ChatGPT и Gemini. 21 сентября мы сняли два замера для одной и той же школы.
Первый замер шёл по набору, где часть вопросов содержала название бренда. Общая видимость получилась 29%. Но внутри цифра неоднородна: по брендовым вопросам около 87%, по открытым около 15%. Ничего удивительного: если в вопросе уже стоит название, нейросеть с большой вероятностью его повторит.
Второй замер шёл по новому набору открытых вопросов без названия бренда. Видимость 6%, AI SOV 5%, citation share 4,2%. По тексту кейса, ChatGPT, Gemini, Claude и DeepSeek не назвали школу ни разу. Упоминания дали только Perplexity и Google AI Overviews, и только по вопросам с городом.
Сайт один, день один, а цифры 29% и 6%. Какая из них «правильная»? Обе, если честно подписать, что именно мерили. Неправильно только выдавать любую из них за «видимость сайта в нейросетях вообще». Это первая и главная мысль статьи, остальные ловушки её развивают.
Ловушка 1. Состав набора вопросов
Как выглядит. В отчёте одна цифра видимости, а в списке вопросов половина содержит название бренда или его слова («отзывы о компании Х», «курсы Х»). Либо наоборот: набор целиком из общих вопросов, а клиент ждёт цифры, как у конкурентов с брендовыми.
Почему цифры расходятся. Брендовые вопросы проверяют, знает ли нейросеть вас, когда о вас уже спросили. Открытые проверяют, назовёт ли она вас, когда человек ещё выбирает. Это два разных вида доверия, и средняя между ними (в нашем случае 29% при 87% и 15% внутри) ничего не описывает. Доля брендовых в наборе сама двигает общую цифру.
Как избежать (наша рекомендация).
- Делите вопросы минимум на два набора: брендовые и открытые, и показывайте цифры отдельно.
- Для оценки реального охвата опирайтесь на открытые вопросы без названия бренда: так человек ищет, пока не знает вас.
- Фиксируйте в отчёте долю брендовых вопросов и не смешивайте новые наборы со старыми: новые вопросы добавляйте отдельным набором.
- Не сравнивайте свою видимость по открытым вопросам с чужой по брендовым.
Ловушка 2. Формулировка вопроса
Как выглядит. Вы переписали вопросы «чуть красивее» или добавили в них город, а после замера сравниваете с прошлым.
Почему цифры расходятся. В нашем сервисе замера свои готовые вопросы (режим своих промптов) уходят в нейросеть и в поисковые поверхности слово в слово: любая правка меняет ответ, поэтому замер проверяет именно ту формулировку, которая была задана. Ещё один случай: если ключевую фразу вроде «seo продвижение минск» отправить в чат как есть, модель ответит рефератом «что такое SEO» вместо списка компаний, поэтому в нашем сервисе такая фраза для чата разворачивается в вопрос. В поисковой строке и в чате люди формулируют по-разному, и измерения тоже будут разными.
Как избежать (наша рекомендация).
- Храните точный текст каждого вопроса и не правьте его между замерами.
- Ключевые фразы из поиска разворачивайте в живой вопрос, как задал бы человек в чате.
- Следите, чтобы формулировка была нейтральной: не подсказывала бренд и не сужала ответ.
- Если вопрос пришлось изменить, считайте это новым вопросом и новым набором.
Ловушка 3. Формула подсчёта: по ответам или по вопросам
Как выглядит. Два отчёта называют метрику одинаково, но считают по-разному. В одном бренд засчитывают, если его назвала хотя бы одна нейросеть, в другом считают каждый ответ.
Почему цифры расходятся. Мы считаем так (как в статье про метрики): видимость равна доле ответов, где бренд назван, то есть ответы, где бренд назван, делённые на все ответы, где все ответы это вопросы, умноженные на нейросети и на прогоны. Единица подсчёта ответ: один вопрос, заданный одной нейросети. Если считать «по вопросам» (хотя бы одна сеть назвала), цифра почти всегда выше, потому что достаточно одного удачного ответа. Наша рекомендация: показывать обе, но подписывать, какая есть какая. В нашем сервисе замера из видимости исключены брендовые вопросы, а также ответы с ошибкой и запросы без AI-блока, а AI SOV считается как взвешенный показатель присутствия (позиция в ответе, ссылка, тип вопроса, тональность), поэтому всегда смотрите, какое определение у цифры в вашем отчёте. AI SOV и citation share тоже имеют правила: в AI SOV нужно заранее решить, считаем ли мы всех названных брендов или только список конкурентов, а citation share работает только у нейросетей, которые показывают источники.
Как избежать (наша рекомендация).
- Запросите у исполнителя формулу в письменном виде: что в числителе, что в знаменателе.
- Сравнивайте только метрики, посчитанные по одной формуле.
- Для AI SOV зафиксируйте список конкурентов и правило: все названные или только выбранные.
- Не складывайте и не усредняйте цифры по нейросетям без весов: проще показывать их рядом.
Ловушка 4. Число и набор нейросетей
Как выглядит. В одном замере 4 нейросети, в другом 7. Или в списке есть Яндекс и Алиса, а в сравниваемом отчёте нет.
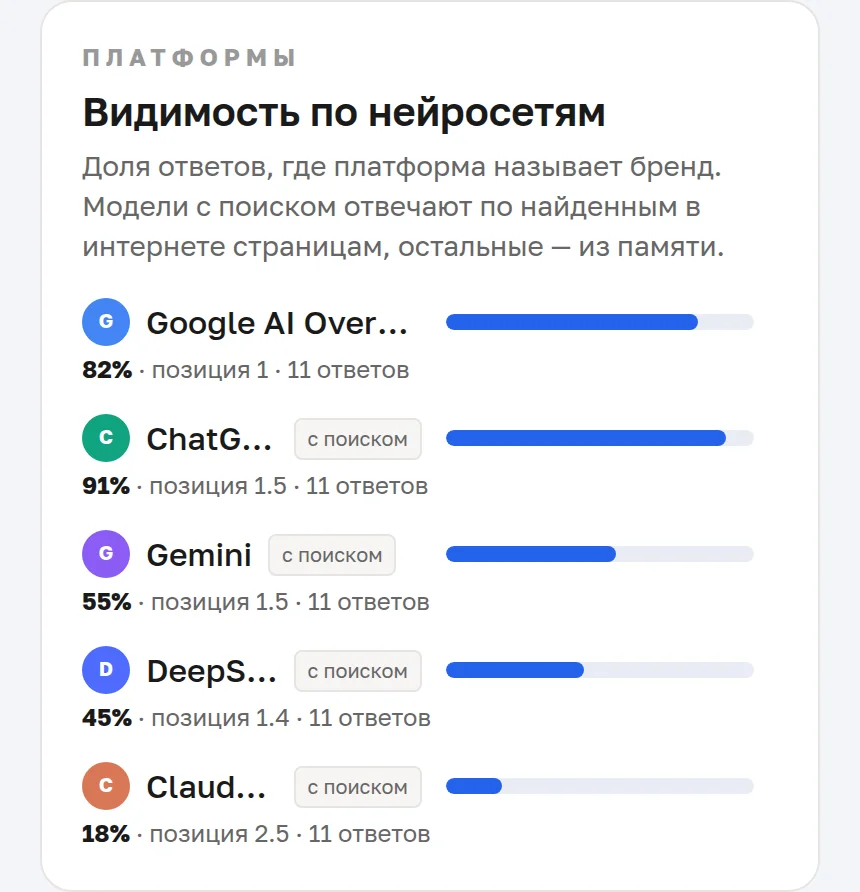
Почему цифры расходятся. Общая цифра это усреднение по сетям, и состав усреднения её меняет. В нашем кейсе в более позднем замере к шести нейросетям добавилась седьмая, Алиса, и сам кейс предупреждает: общий рост включает эффект добавленной сети, поэтому его нельзя читать как чистый рост. Корректно сравнивать только те нейросети, которые были в обоих замерах. Кроме того, у разных сетей разное поведение: в замере открытых вопросов четыре из них не назвали школу ни разу, а упоминания дали две другие.
Как избежать (наша рекомендация).
- Заранее зафиксируйте список нейросетей и держите его неизменным; наша рекомендация по метрикам: 5–7 нейросетей.
- Показывайте видимость по каждой сети отдельно, а не только общую.
- При добавлении новой сети пересчитывайте динамику только по общим для двух замеров.
- Выбирайте сети, которыми пользуется ваша аудитория в вашей стране.
Ловушка 5. Ответ из памяти и ответ с поиском
Как выглядит. Одна и та же сеть отвечает по-разному в зависимости от режима и поверхности: в обычном чате, в чате с поиском по интернету, в поисковом блоке с ИИ.
Почему цифры расходятся. Мы замеряем разные поверхности: нейросети (ChatGPT, DeepSeek, Perplexity, Gemini, Claude) и поисковые блоки с ИИ (Google AI Overview и Поиск с Алисой). Это не одно и то же. Ответ модели из собственных знаний зависит от обучающих данных и обновляется редко, а ответ с поиском строится на актуальных страницах и ссылках. Какой режим включён у конкретной сети в вашем инструменте, нужно проверять на странице инструмента: мы не будем утверждать это за всех. Про Google есть и официальное уточнение: по документации Search Central, Режим ИИ и Обзор от ИИ могут использовать разные модели и методики, поэтому наборы ссылок отличаются. Значит, «видимость в Google» без уточнения, какая именно функция измерялась, это уже две разные цифры.
Как избежать (наша рекомендация).
- Записывайте для каждой сети: режим (с поиском или без), поверхность и способ получения ответа.
- Не смешивайте в одной цифре чаты и поисковые блоки с ИИ: показывайте их по отдельности.
- Для Google указывайте, что измерено: Обзоры от ИИ или Режим ИИ.
- Помните, что Обзор показывается не на каждый запрос: по справке Google, он появляется, если системы сочтут его полезным.
Ловушка 6. Повторные прогоны одного вопроса
Как выглядит. В отчёте один ответ на вопрос, а вывод звучит как «нейросеть нас не рекомендует».
Почему цифры расходятся. Ответ нейросети меняется от прогона к прогону, поэтому один ответ это наблюдение, а не измерение. Не случайно в формуле выше число прогонов входит в знаменатель. Наша рекомендация из статьи о метриках: три прогона на каждый вопрос в чистых чатах, два прогона достаточно для проверки гипотезы, но перед решением о бюджете нужны три. Чистый чат важен потому, что история диалога влияет на ответ.
Как избежать (наша рекомендация).
- Делайте минимум 2–3 прогона на вопрос и указывайте число в отчёте.
- Каждый прогон в новом чате без истории и персональных настроек.
- Считайте и показывайте разброс между прогонами, если он большой, не делайте выводов по одному.
- Не сравнивайте замер с тремя прогонами и замер с одним.
Ловушка 7. Регион и язык вопроса
Как выглядит. Вопросы в замере общие («лучшие компании в России»), а бизнес работает в одном городе. Или наоборот: в вопросах зашит город, которого нет у клиента.
Почему цифры расходятся. В вопросах зашита география, и от неё зависит, кого назовёт модель. В нашем сервисе регион определяется по сайту клиента: по телефонному коду в контактах, по городу в заголовке и тексте и так далее, а список городов доставки регионом не считается. Для столицы вопросы чередуем в формате «город или страна», а для регионального города чередование отключено: по запросу «по всей России» региональную компанию почти не назовут, и половина замера почти наверняка уйдёт в ноль. В нашем кейсе упоминания Perplexity и Google AI Overviews появились только по вопросам с городом. Язык тоже важен: вопрос на русском и на английском может дать разные списки.
Как избежать (наша рекомендация).
- Определяйте регион по сайту и контактам клиента, а не по умолчанию.
- Формулируйте вопросы на том языке и в том регионе, где их задаёт ваш клиент.
- Для регионального бизнеса не добавляйте вопросы «по всей стране».
- При смене региона пересобирайте набор вопросов целиком: старый город остаётся в формулировках.
Ловушка 8. Знаменатель и запросы без AI-блока
Как выглядит. В поисковых поверхностях часть запросов вообще не получает ИИ-ответа. В отчёте они то ли считаются нулями, то ли исчезли без объяснения.
Почему цифры расходятся. В нашем сервисе отсутствие AI-блока это не ошибка, а результат «окно возможности»: такой запрос исключается из знаменателя и помечается в отчёте отдельно. Если считать его нулём, видимость занижается из-за самого поиска, а не из-за вашего сайта. Если исключать без пометки, непонятно, на скольких запросах построена цифра. В другом нашем кейсе, по пулу из 940 запросов (информационный трек из 779 запросов), доля ответов с AI-блоком оставалась на уровне 46%, то есть больше половины запросов ИИ-блока не получали, и для них видимость в таком блоке просто не определена.
Как избежать (наша рекомендация).
- Фиксируйте правило: запросы без AI-блока исключаются из знаменателя, но показываются отдельно.
- Отчёт должен содержать долю запросов с AI-блоком и число запросов, вошедших в расчёт.
- Не складывайте видимость в блоках и в чатах в одно число.
- Следите за долей запросов с AI-блоком как за отдельным показателем, он тоже меняется.
Ловушка 9. Дата замера и смена моделей
Как выглядит. Замеры от разных месяцев лежат в одной таблице как будто это один непрерывный ряд.
Почему цифры расходятся. Между двумя замерами нейросеть может поменять модель, источники или настройки поиска, а в справке Google по Режиму ИИ сказано, что описанные параметры могут не совпадать с текущими, так как Google обновляет настройки сервисов Поиска. Доступа к внутренним системам ИИ Google у сторонних инструментов нет, это сказано в руководстве Google по ИИ-оптимизации. Значит, причину изменения цифры нужно искать аккуратно: сайт поменялся, или поменялся источник ответов. Отдельно: в нашем сервисе часть ответов (например, Алисы) дозагружается вторым этапом, и цифры в отчёте после этого меняются, поэтому замер, пока часть данных ещё собирается, не стоит выдавать за итог.
Как избежать (наша рекомендация).
- Всегда пишите дату и время замера, а не только месяц.
- Отмечайте события: смену моделей, запуск функции в вашей стране, правки на сайте.
- Не показывайте клиенту цифру, пока замер не закончен целиком.
- Для Google дополнительно смотрите отчёт Search Console по генеративному ИИ: он показывает показы страниц в Обзорах и Режиме ИИ вместе.
Ловушка 10. Один замер вместо серии
Как выглядит. Вы сняли одну цифру и принимаете по ней решение: поднять бюджет, сменить подрядчика, закрыть направление.
Почему цифры расходятся. Один замер это срез с погрешностью: прогоны, дата, состав вопросов, набор сетей. Небольшую разницу, например между 6% и 8%, на одном срезе легко принять за шум. Поэтому контрольный набор должен жить без правок минимум квартал (наша рекомендация), а новые вопросы добавляются отдельным набором. И сравнивать нужно набор с самим собой во времени, а не с чужим набором.
Как избежать (наша рекомендация).
- Задайте контрольный набор вопросов и не меняйте его минимум квартал.
- Делайте серию замеров через равные промежутки, одинаковыми условиями.
- Смотрите тренд, а не отдельную точку.
- Решения о бюджете принимайте после нескольких замеров и трёх прогонов на вопрос.
Сводный чек-лист и что делать сайту
Перед тем как поверить любой цифре видимости, в том числе нашей, проверьте шесть параметров из таблицы. Если по какому-то параметру записи нет, цифра неполная.
| Параметр | Что должно быть записано рядом с цифрой |
|---|---|
| Набор вопросов | Число вопросов, доля брендовых, точные формулировки |
| Нейросети | Список, режим (с поиском или без), поверхность |
| Прогоны | Число прогонов на вопрос, чистые чаты |
| Регион и язык | Город и страна, откуда взяты, язык вопросов |
| Формула | Что в числителе и знаменателе, как учтены запросы без AI-блока |
| Дата | Дата и время, статус «замер завершён» |
Что делать сайту
- Составьте два набора вопросов: брендовые и открытые; по нашей рекомендации, в сумме 25–30 вопросов клиента.
- Выберите 5–7 нейросетей и не меняйте их список.
- Сделайте минимум три прогона на вопрос в чистых чатах.
- Определите регион по сайту и сформулируйте вопросы на языке клиента.
- Запишите формулу и правило для запросов без AI-блока.
- Повторяйте замер по расписанию и сравнивайте только сопоставимые замеры.
- Рядом с цифрой всегда приводите описание условий замера.
Как провести замер руками, без инструментов, подробно в отдельной статье. Как отслеживать упоминания бренда в ответах постоянно, подробно в отдельной статье. Общий план работы над видимостью описан в инструкции по продвижению бизнеса в нейросетях.
Сделайте за 15 минут откройте последний отчёт по видимости, который у вас есть, и выпишите в столбик шесть параметров из таблицы выше. Для каждого напишите, указан ли он в отчёте. Каждый пропуск это вопрос к исполнителю до следующего совещания.
Если хотите научиться строить такие замеры и читать их без иллюзий, у нас есть курс по нейросетям: там мы разбираем работу с нейросетями. Это приглашение, а не обещание результата.
Частые вопросы
Какая цифра видимости «правильная»: 6% или 29%?
Обе могут быть верны. В нашем случае 29% это замер, где часть вопросов содержала бренд, а 6% это замер открытых вопросов без названия бренда. Для оценки охвата новых клиентов ближе вторая, но обе нужно подписывать.
Сколько вопросов и прогонов нужно для замера?
Наша рекомендация: 25–30 вопросов клиента, 5–7 нейросетей и три прогона на вопрос в чистых чатах. Два прогона достаточно для проверки гипотезы, перед решением о бюджете нужны три. Это практика, а не правило нейросетей.
Можно ли сравнивать свой замер с замером конкурента?
Только если совпадают набор вопросов, нейросети, число прогонов, регион и формула. На практике чужие замеры чаще несопоставимы, поэтому надёжнее сравнивать себя с собой во времени.
Почему запросы без AI-блока не считаются?
Если ИИ-ответа нет, видимость в нём не определена. Мы исключаем такие запросы из знаменателя и показываем отдельно, чтобы не занижать цифру и не прятать долю таких запросов.
Влияет ли смена модели нейросети на результат?
Может влиять. Сторонние инструменты не видят внутренних систем нейросетей и Google, поэтому причину изменения нужно искать осторожно: фиксировать даты и события и повторять замер.
Совпадает ли Режим ИИ Google с Обзорами от ИИ?
Нет, по документации Google они могут использовать разные модели и методики, поэтому наборы ссылок отличаются. Измеряйте и подписывайте их отдельно.
Хватит ли одного замера, чтобы показать результат руководителю?
Как стартовая точка да, как доказательство нет. Нужны контрольный набор и серия замеров с одинаковыми условиями.
Источники
- Google Search Central: оптимизация сайта для ИИ-функций
- Google Search Central: руководство по оптимизации для ИИ
- Справка Google: Обзоры от ИИ
- Справка Google: режим ИИ
- Справка Search Console: отчёт об эффективности для генеративного ИИ в Поиске
Данные про замеры 21 сентября взяты из нашего кейса, формулы и рекомендации по прогонам из нашей статьи про метрики, правила регионов и знаменателя из описания нашего сервиса замера.
Обновлено: октябрь 2026. Страница пересматривается каждые 60 дней.

